
KVCache SSD分级缓存参考实践
发表于: 2026/06/30
1. 非商用声明
该文档提供的内容为参考实践,仅供用户参考使用,用户可参考实践文档构建自己的软件,按需进行安全、可靠性加固,但不建议直接将相关Demo或镜像文件集成到商用产品中。
2. 方案介绍
2.1 背景
个人AI助手多轮连续对话或者AI 编程的超长上下文等典型业务场景中,KV Cache 复用率可达 80% 以上。Prefix-Cache特性默认使用HBM(芯片片上内存)进行缓存,受限于HBM容量,缓存空间有限,缓存命中率低。通过构建HBM+DDR+SSD的三级缓存方案,使用更便宜的存储介质大幅增加缓存存储空间,提高缓存命中率,降低推理的首字时延,提升系统性能和用户体验。
2.2 方案简介
本方案包含vLLM Ascend+MemCache+MemFabric组件,通过构建HBM+DDR+SSD三级KVCache缓存方案,增大缓存空间,提高缓存命中率,降低大模型推理的首字时延,优化模型性能。
整体架构如图所示: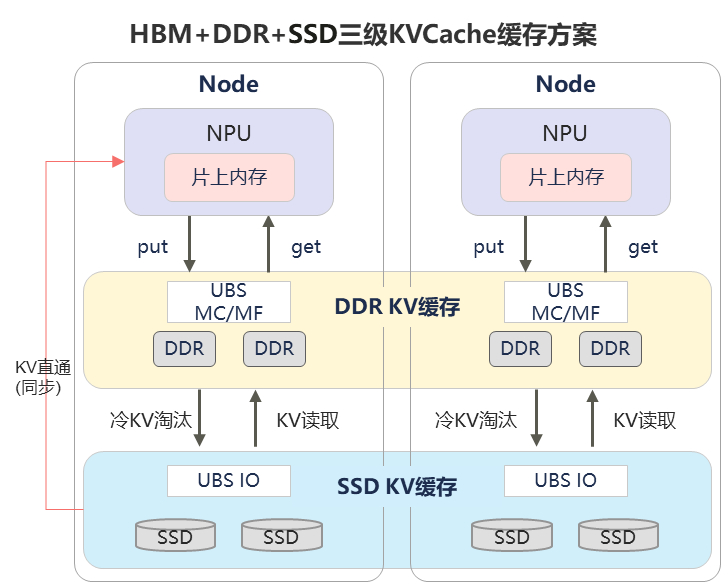
相关组件代码仓链接为:
MemCache:https://gitcode.com/Ascend/memcache
MemFabric:https://gitcode.com/Ascend/memfabric_hybrid
2.3 典型配置
本特性支持的硬件为:Atlas 300I A2、Atlas 800I A2和Atlas 800I A3。
表1 软件版本
| 软件/镜像 | 版本 | 说明 |
|---|---|---|
| Ascend HDK | 25.5.1 | NPU驱动固件,要求不低于25.5.1 |
| vLLM Ascend | 0.23.0 | 昇腾硬件插件,用于在 Ascend NPU 上运行 vLLM,建议不低于0.23.0 |
| Docker | 18.09.0 | 用于部署容器,推荐18.09.x~28.5.1版本 |
| MemFabric | 1.2.0 | 内存池化基础软件,用于实现DRAM与显存混合池化,提供极简的内存访问接口和高性能的内存直接访问能力,支撑多种场景下的数据共享与传输 |
| MemCache | 1.2.0 | 针对AI推理场景设计的高性能分布式KVCache存储引擎 |
| AISBench | 3.0-20251219-master | 大模型推理性能测评工具,不影响服务部署 |
| OS | openEuler 22.03 (LTS-SP4) | 物理机OS,以昇腾解决方案要求为准。建议系统内核不低于5.10。 |
表2 推荐使用的模型列表
| 部署模式 | 支持模型 |
|---|---|
| Atlas 800I A2 单机 | MinMax-M2.5-w8a8、 Qwen3.5-27B-w8a8 |
| Atlas 800I A2 双机 | GLM5.1/2-w8a8 |
| Atlas 800I A3 单机 | MinMax-M2.5-w8a8、GLM5.1/2-w8a8 |
| Atlas 800I A3 双机 | GLM5.1/2-w8a8 |
| Atlas 300I A2 单机双卡 | Qwen3.5-27B-w8a8 |
3. 部署指导
3.1 前置条件
- 已完成OS、昇腾HDK、Docker安装,并已下载对应大模型的权重文件和测试数据集(或者使用自动化部署工具进行依赖安装和下载权重),集群(多机互联)场景下需完成参数面组网,确保网络互通。
- KV Cache 三级缓存推荐使用本地 NVMe 磁盘部署,服务运行中会占用大量磁盘IO吞吐,尽量独占或者不和其它业务冲突。
- 若使用自动化工具拉起,则还需要确保主节点当前执行用户为 root 用户、确保磁盘空间充足(本工具下载的镜像及模型默认保存在工具所在目录,至少 100GB,取决于模型大小)、执行下载的机器已安装docker。
3.2 部署流程
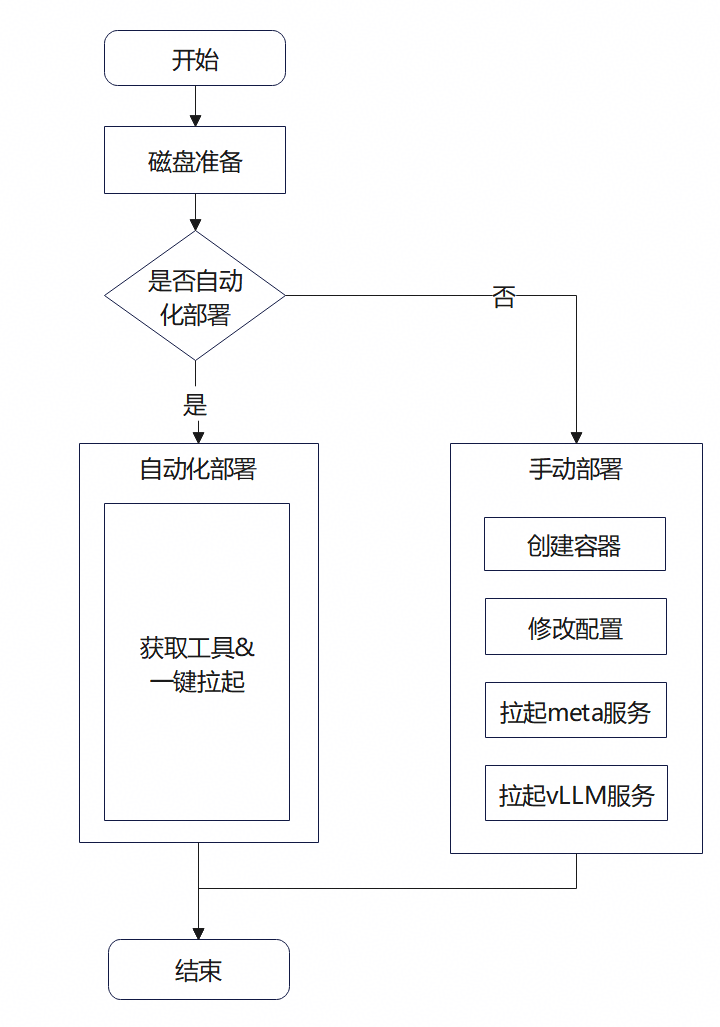
部署方式分为自动化部署和手动部署,部署流程如图所示:
3.3 具体步骤
支持自动部署和手动部署两种方式,用户可按需选择其中一种即可。
3.3.1 磁盘准备
配置详情可参考此链接中的设备配置章节。
方案1:使用裸盘
若提供给分级缓存使用的NVMe盘为独占盘且未挂载,可直接使用,可用该示例检查是否挂载(替换为真实磁盘):lsblk /dev/nvme0n1,回显结果中MOUNTPOINTS没有值则为未挂载。
方案2:创建loop设备
如果无独占的空闲盘,可使用loop设备方案,复用已有磁盘空间,操作如下:
# 创建并预分配 1TB 镜像文件,容量可按需调整(路径需自行创建,且位于目标硬盘上,例如/data)
sudo fallocate -l 1T /data/ubsio_disk.img

# 创建 loop 设备并输出系统实际分配的设备路径
LOOP_DEV=$(sudo losetup --find --show --direct-io=on /data/ubsio_disk.img)
echo "${LOOP_DEV}"
# 示例输出:/dev/loop0
# 注意,需要记住此处的设备值,后续拉起服务时需要指定。
取消 loop 设备的方式如下,注意, 仅在确认不再需要 loop 模拟盘且相关服务已经停止时执行,卸载后缓存数据将丢失。
# 1. 查看当前 loop 设备及其关联文件
losetup -a

# 2. 卸载 loop 设备,替换为实际设备路径
sudo losetup -d /dev/loop0

# 3. 删除镜像文件(可选)
sudo rm -f /data/ubsio_disk.img
3.3.2 自动化部署
KADT工具已新增三级缓存特性,支持开启三级缓存的自动化部署,从而进一步简化从下载到部署的完整流程,帮助用户快速搭建 LLM 推理服务。
获取部署工具:
首先克隆代码仓,获取用于安装和部署基于 vLLM Ascend 的 LLM 模型服务的自动化脚本。代码仓地址:自动化部署工具代码仓
若已安装git,可直接克隆本仓库:
git clone https://gitcode.com/Ascend/ascend-deployer.git -b appliance_deployer --single-branch(注:以下所涉及脚本所在文件夹目录:kadt/llm_service)
适用范围:
使用自动化方式部署时需保证所用OS与模型已被KADT工具支持。可使用 ./install_llm.sh --help 查看支持分级缓存的模型,详细内容可参考README。
3.3.2.1 单机部署
以Atlas800I A2机型、OpenEuler操作系统,单机2卡部署Qwen3.5-27B-w8a8-mtp模型(开启三级缓存)为例,命令中涉及到的参数请根据实际使用场景进行设置。
步骤一、下载软件包和LLM模型
cd ascend-deployer/kadt/llm_service
bash download.sh --os OpenEuler_24.03LTS-SP1_aarch64 --model Eco-Tech/Qwen3.5-27B-w8a8-mtp --download-mode
执行该命令后会一键下载vLLM-Ascend镜像、NPU驱动与固件、操作系统依赖等软件包,以及对应的模型权重文件。说明:
1. --os :指定操作系统类型,在Linux 系统中可执行 cat /etc/os-release 命令查看操作系统类型
2. 模型权重默认下载到代码仓根目录下的 model_weights/,建议用户合理安排代码仓位置。
3. 若不需要下载权重,则删去 --download-model。
步骤二、安装基础软件
bash install_base_sw.sh该命令会将步骤一中下载的操作系统依赖、NPU驱动与固件等进行一键安装。如已安装驱动与固件且当前版本驱动固件与 vLLM-Ascend 镜像中的 CANN 版本匹配,请不要选择安装npu,以避免重启服务器。
步骤三、拉起LLM模型服务
bash install_llm.sh --model Qwen3.5-27B-w8a8-mtp --port 8911 --api-key 1111 --devices [4,5] --privileged true --memcache l3 --ssd-disk-path /dev/loop0 说明:
1. 若在步骤一中未下载模型权重,需添加参数 --weight_path 指定本机下载好权重的目录,如:--weight_path /data/weights
2. Qwen3.5-27B-w8a8-mtp默认2卡部署,可通过 npu-smi info 查看空闲的卡编号,将编号填入--devices 中。
3. --ssd-disk-path 为3.3.1章节中准备的未挂载且独占的盘。
4. --port 需要确认指定端口未被占用,可用 netstat -tulpn | grep :<端口号> 没有任何输出表示该端口未被占用。
5. --api-key 由用户指定。
具体参数含义详见README。
步骤四、模型服务使用示例
curl http://127.0.0.1:8911/v1/chat/completions \    # 请替换为实际的ip、port
-H "Content-Type: application/json" \
-H "Authorization: Bearer 1111" \    # 请替换为实际的api_key
-d '{
"model": "Qwen3.5-27B-w8a8-mtp",
"prompt": "介绍一下你自己",
"temperature": 0,
"max_tokens": 100
}'
ip、port、api_key注意替换为实际配置。
可选:卸载模型服务
# 查看所有容器
docker ps -a
# 停止并删除 vllm_ascend_0 容器
docker stop vllm_ascend_0
docker rm vllm_ascend_0
容器名默认为 vllm_ascend_x 格式(如 vllm_ascend_0、vllm_ascend_1 等),卸载容器不会删除模型权重文件,如需彻底清理请手动删除 --weight_path 指定的模型权重目录。
3.3.2.2 双机部署
以Atlas800I A2机型、OpenEuler操作系统,双机全卡部署GLM-5.2-w8a8c8模型(开启三级缓存)为例,命令中涉及到的参数请根据实际使用场景进行设置。
步骤一、配置多机节点信息
需要将主从节点的信息配置到部署工具的 ascend_deployer/inventory_file 文件中,以下方式二选一:
1. 免密登录(推荐)
推荐在多台机器之间配置 SSH 免密登录(可参考远程连接服务器),以提升安全性与自动化部署体验。完成免密登录配置后在 ./ascend_deployer/inventory_file文件中配置服务器信息:
[worker]
11.11.11.1 ansible_ssh_user="root"        # 请替换为实际待安装设备的 IP(推荐免密方式)
11.11.11.2 ansible_ssh_user="root"        # 请替换为实际待安装设备的 IP(推荐免密方式)
2. 密码登录
如果无法使用免密登录,可在 ./ascend_deployer/inventory_file 中临时填写密码以便自动批量执行,但存在泄露风险,部署完成后请务必移除密码字段。
[worker]
11.11.11.1 ansible_ssh_user="root" ansible_ssh_pass="your_password"
11.11.11.2 ansible_ssh_user="root" ansible_ssh_pass="your_password"
注意:使用双机部署 LLM 模型服务时,[worker] 的第一台设备为主节点,脚本后续操作基于该主节点进行双机模型部署,即以下操作只需要在主节点执行。
步骤二、下载软件包和LLM模型
cd ascend-deployer/kadt/llm_service
bash download.sh --os OpenEuler_24.03LTS-SP1_aarch64 --model Eco-Tech/GLM-5.2-w8a8c8 --download-model
执行该命令后会一键下载vLLM-Ascend镜像、NPU驱动与固件、操作系统依赖等软件包,以及对应的模型权重文件。说明:
1. --os :指定操作系统类型,在Linux 系统中可执行 cat /etc/os-release 命令查看操作系统类型。
2. 若不需要下载模型权重,则删去 --download-model,此操作需保证所有主、从节点都有模型权重,且权重路径和主节点保持一致。
步骤三、安装基础软件
bash install_base_sw.sh该命令会将步骤一中下载的操作系统依赖、NPU驱动与固件等进行一键安装。如已安装驱动与固件且当前版本驱动固件与 vLLM-Ascend 镜像中的 CANN 版本匹配,请不要选择安装npu,以避免重启服务器。
步骤四、拉起服务
双机混部部署时,需要在每个节点上进行磁盘准备,见于3.3.1章节。
通过 CLI 或 inventory 传入路径后执行命令,启动开启了L3分级缓存特性的模型服务:
# CLI 方式(所有节点用同一盘路径时)
bash install_llm.sh --model GLM-5.2-w8a8c8  --port 8911 --api-key 1111 --instance-node-num 2 --memcache l3 --ssd-disk-path /dev/nvme0n1

# inventory 方式(多机部署各节点盘路径不同时推荐)
# 修改代码仓的 ascend_deployer/inventory_file 文件, [worker] 每节点行配置
11.11.11.1 ansible_ssh_user="root" ansible_ssh_pass="your_password" ssd_disk_path="/dev/nvme0n1"
11.11.11.2 ansible_ssh_user="root" ansible_ssh_pass="your_password" ssd_disk_path="/dev/nvme1n1"

bash install_llm.sh --model GLM-5.2-w8a8c8  --port 8911 --api-key 1111 --instance-node-num 2 --memcache l3    #若已在inventory_file 文件中配置了ssd_disk_path,则命令行不需要传入--ssd-disk-path
说明:
1. 若在步骤一中未下载模型权重,需添加参数 --weight_path 指定下载好权重的目录,要求所有机器的权重路径相同,如:--weight_path /data/weights。
2. --ssd-disk-path 为3.3.1章节中准备的未挂载且独占的盘。
3. --port 需要确认指定端口在主节点上未被占用,可用 netstat -tulpn | grep :<端口号> 没有任何输出表示该端口未被占用。
4. --api-key 由用户指定。
具体参数含义详见README。
步骤五、模型服务使用示例
curl http://11.11.11.1:8911/v1/chat/completions \    # 请替换为实际的主节点ip、port
-H "Content-Type: application/json" \
-H "Authorization: Bearer 1111" \    # 请替换为实际的api_key
-d '{
"model": "GLM-5.2-w8a8c8",
"prompt": "介绍一下你自己",
"temperature": 0,
"max_tokens": 100
}'
ip、port(对应主节点信息)、api_key注意替换为实际配置的配置。
可选:卸载模型服务
在所有节点上执行以下命令:
# 查看所有容器
docker ps -a
# 停止并删除 vllm_ascend_0 容器
docker stop vllm_ascend_0
docker rm vllm_ascend_0
容器名默认为 vllm_ascend_x 格式(如 vllm_ascend_0、vllm_ascend_1 等),卸载容器不会删除模型权重文件,如需彻底清理请手动删除 --weight_path 指定的模型权重目录。
3.3.3 手动部署
3.3.3.1 创建容器
本文介绍使用容器部署vLLM Ascend的方式,镜像下载地址:https://quay.io/repository/ascend/vllm-ascend?tab=tags
单机部署和双机部署,均参考如下操作步骤:
# docker拉取镜像(以A2的openeuler镜像为例)
# 也可以采用下载镜像的tar包,然后使用docker load -i xx.tar的方式安装镜像
docker pull quay.io/ascend/vllm-ascend:v0.23.0

# 根据实际下载镜像版本进行替换
export IMAGE=quay.io/ascend/vllm-ascend:v0.23.0

# 查看NPU设备号
ls /dev/davinci*
# 根据查询到的davinci设备号,配置容器创建时的device参数
/dev/davinci0  /dev/davinci1  /dev/davinci2  /dev/davinci3  /dev/davinci4  /dev/davinci5  /dev/davinci6  /dev/davinci7  /dev/davinci_manager

# 构建容器,注意权重挂载路径根据真实情况替换,NPU卡数据根据实际情况替换(此处以8卡为例)
docker run -itd --net=host --privileged=true \  # 若不启用特权容器,需对磁盘分区做设备映射挂载。
       --shm-size=256g \ # 如果为300I A2场景(单机),配置protocol为host_shm,需要保证shm-size值大于二级缓存总内存
       --name vllm-ascend-usbio \        # 依据实际情况配置
       -v /usr/local/dcmi:/usr/local/dcmi \
       -v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
       -v /usr/local/Ascend/driver/:/usr/local/Ascend/driver \
       -v /etc/ascend_install.info:/etc/ascend_install.info \
       -v /home:/home \     # 根据真实情况替换(例如权重,脚本等),执行时删除注释,不要有空格
       -v /root/.cache:/root/.cache \
       --device /dev/davinci0 \  # 依据实际情况配置,执行时删除注释,不要有空格
       --device /dev/davinci1 \
       --device /dev/davinci2 \
       --device /dev/davinci3 \
       --device /dev/davinci4 \
       --device /dev/davinci5 \
       --device /dev/davinci6 \
       --device /dev/davinci7 \
       --device /dev/davinci_manager \
       --device /dev/devmm_svm \
       --device /dev/hisi_hdc \
       -it $IMAGE bash

# 进入容器
docker exec -it vllm-ascend-usbio bash
3.3.3.2 安装memcache与memfabric(可选)
vLLM-Ascend 0.23.0镜像默认内置memcache 1.2.0,如果使用其它环境,可采用手动安装的方式。
使用pip命令进行安装,参考命令如下(如果有网络问题,可加-i https://pypi.tuna.tsinghua.edu.cn/simple/参数使用镜像源):
# 1. 先安装 MemFabric
pip install memfabric_hybrid==1.2.0

# 2. 再安装包含 UBSIO 的 MemCache
pip install memcache_hybrid==1.2.0

# 3. 验证 Python 包安装成功,正常时回显为“import-ok”
python3 -c "import memfabric_hybrid, memcache_hybrid; print('import-ok')"
3.3.3.3 修改配置文件
详细的参数含义可参考此链接。
配置文件会随着pip install自动下载,下载路径可通过如下命令获取:
# 相关配置文件会安装到对应目录下,获取命令如下
MMC_CONFIG_DIR="$(python3 -c 'from pathlib import Path; import memcache_hybrid; print(Path(memcache_hybrid.__file__).resolve().parent / "config")')"
echo "$MMC_CONFIG_DIR"
目录下会有mmc-meta.conf和mmc-local.conf配置文件,最小修改如下:
1. mmc-meta.conf配置
修改命令:vim $MMC_CONFIG_DIR/mmc-meta.conf
# 将IP配置为主节点IP,端口可根据实际情况修改
ock.mmc.meta_service_url = tcp://xx.xx.xx.xx:5000
ock.mmc.local_service.config_store_url = tcp://xx.xx.xx.xx:6000
ock.mmc.meta_service.metrics_url = http://xx.xx.xx.xx:8000

# 空间使用率达到高水位时,Put 操作触发数据淘汰
ock.mmc.evict_threshold_high = 70

# 数据淘汰完成后的目标空间使用率,即低水位
ock.mmc.evict_threshold_low = 60

# DRAM 空间使用率达到该水位时,淘汰时会快速删除数据释放内存,降低内存占用压力。
ock.mmc.rewarm.dram_watermark = 95
2. mmc-local.conf配置
修改命令:vim $MMC_CONFIG_DIR/mmc-local.conf
# 将IP配置为主节点IP,端口可根据实际情况修改
ock.mmc.meta_service_url = tcp://xx.xx.xx.xx:5000
ock.mmc.local_service.config_store_url = tcp://xx.xx.xx.xx:6000

# 根据不同硬件设备,配置为对应值:
# 800I A3场景(单双机),配置为device_sdma
# 800I A2场景(单双机),配置为device_rdma
# 300I A2场景(单机),配置为host_shm
ock.mmc.local_service.protocol = device_rdma

# 每device分配的内存空间,即DRAM二级缓存大小,可根据实际场景调整,调整方式后文单独说明
ock.mmc.local_service.dram.size = 20GB

# 启用 SSD 池化特性开关
ock.mmc.local_service.storage.enabled = true

# 配置 UBS IO 用作本地 SSD 缓存的块设备路径,支持整盘、分区或 loop 设备;多个路径使用英文冒号分隔;配置的设备必须由 UBS IO 独占,且不能存在挂载点
ubsio.disk.path = /dev/loop0:/dev/loop1:/dev/loop2

# UBS IO 单进程内存池大小,单位 GB。典型配置:推荐配置为10GB,建议不小于5G。
ubsio.mem.size_in_gb = 10

# 启动vLLM服务的device数量
ubsio.standalone.device_count = 8

# 非灵衢场景,建议配置此功能为false
ubsio.bdm.batch_read.standalone.use_scratch_pool = false
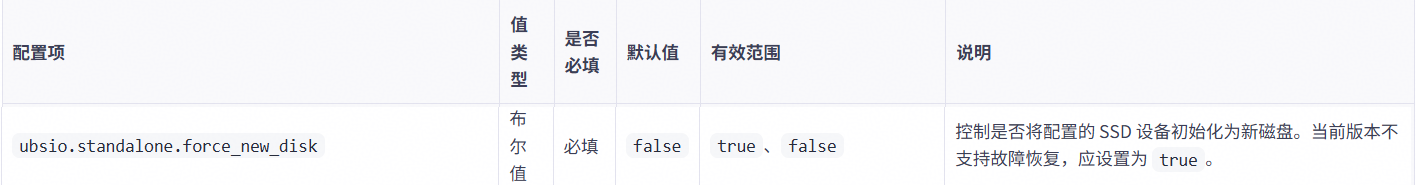
此外,当前版本建议new_disk参数配置为true,后续版本会进行更新。
当前方案数据传输路径为从HBM(NPU)到DRAM(二级缓存),再到SSD(三级缓存)。所以使能三级缓存需要同时使能二级缓存,也就是服务器除了需要预留SSD磁盘空间,还需要预留一定的内存空间。
对内存的主要空间占用有二级缓存大小(ock.mmc.local_service.dram.size)和ubsio进程占用(ubsio.mem.size_in_gb),2个参数配置的都是每device占用,总空间占用需要乘以device数量,计算公式如下:
总内存占用 = device_count *(dram.size + mem.size_in_gb)
在DRAM受限的SSD缓存场景,DRAM主要用于KVCache数据传输,当前给的推荐值是20GB。如果DRAM空间充裕,也可配置较大DRAM空间将DRAM和SSD同时作为主力存储介质。如果想要在20G往下减少此配置节约内存,可根据实际服务和请求所需的KVCache大小进行调整,从vLLM服务日志中抓取相关信息进行估算。注意,不同max-model-length配置下,vllm服务打印的GPU KV cache size值会不同(部分模型存在长度越大,平均每token占用磁盘空间越小的情况),建议使用目标请求长度拉起 一次vLLM服务,获取相对准确的KVCache空间占用。
# 每device的KVCache存储空间大小
Available KV cache memory: 13.88 GiB

# 服务总KVCache大小
GPU KV cache size: 1,217,457 tokens

# 使用KVCache信息和请求负载,预设淘汰水位系数为1.5,推荐使用如下公式估算所需内存空间
每device所需内存 = 并发 * 请求平均长度 * 1.5 * KVC_memory / KVC_size
3.3.3.4 拉起服务
场景一:单机服务
拉起单机vLLM Ascend服务,增加开启三级缓存特性的参数,原有业务的配置参数(如卡号,权重等)保持不变。
步骤一 启动meta_service
MMC_CONFIG_DIR="$(python3 -c 'from pathlib import Path; import memcache_hybrid; print(Path(memcache_hybrid.__file__).resolve().parent / "config")')"
export MMC_META_CONFIG_PATH="$MMC_CONFIG_DIR/mmc-meta.conf"
python3 -c "from memcache_hybrid import MetaService; MetaService.main()"
步骤二 在原有vLLM启动脚本中,增加如下内容,开启三级缓存
# 增加环境变量
MMC_CONFIG_DIR="$(python3 -c 'from pathlib import Path; import memcache_hybrid; print(Path(memcache_hybrid.__file__).resolve().parent / "config")')"
export MMC_LOCAL_CONFIG_PATH="$MMC_CONFIG_DIR/mmc-local.conf"

# vLLM服务启动命令增加如下参数
--kv-transfer-config \
'{
    "kv_connector": "AscendStoreConnector",
    "kv_role": "kv_both",
    "kv_connector_extra_config":{
    "backend": "memcache",
    "lookup_rpc_port": "0"
    }
}'
步骤三 使用完整命令拉起vLLM服务
nic_name="eth0"        # 根据实际网卡名配置
local_ip="xx.xx.xx.xx" # 配置为当前节点IP
export HCCL_IF_IP=$local_ip
export GLOO_SOCKET_IFNAME=$nic_name
export TP_SOCKET_IFNAME=$nic_name
export HCCL_SOCKET_IFNAME=$nic_name

export HCCL_OP_EXPANSION_MODE="AIV"
export HCCL_BUFFSIZE=512

sysctl -w vm.swappiness=0
sysctl -w kernel.numa_balancing=0
sysctl kernel.sched_migration_cost_ns=50000

export TASK_QUEUE_ENABLE=1
export PYTORCH_NPU_ALLOC_CONF=expandable_segments:True
export VLLM_ASCEND_ENABLE_FLASHCOMM1=1
export HCCL_INTRA_PCIE_ENABLE=1
export HCCL_INTRA_ROCE_ENABLE=0
export OMP_PROC_BIND=false
export OMP_NUM_THREADS=8
export VLLM_TORCH_PROFILER_WITH_STACK=0
export VLLM_TORCH_PROFILER_DIR="./profile"

MMC_CONFIG_DIR="$(python3 -c 'from pathlib import Path; import memcache_hybrid; print(Path(memcache_hybrid.__file__).resolve().parent / "config")')"
export MMC_LOCAL_CONFIG_PATH="$MMC_CONFIG_DIR/mmc-local.conf"

LOG_FILE="logs/mix_$(date +%Y-%m-%d-%H-%M).log"
# vllm启动参数参考出口基线配置
vllm serve /data/weights/MiniMax-M2.5-W8A8 \    # 权重路径根据实际调整
    --served-model-name MiniMax-M2.5 \
    --host 0.0.0.0 \
    --port 7000 \
    --trust-remote-code \
    --tensor-parallel-size 8 \
    --quantization ascend \
    --enable-expert-parallel \
    --enable-chunked-prefill \
    --enable-prefix-caching \
    --max-num-seqs 200 \
    --seed 1024 \
    --max-num-batched-tokens 6144 \
    --compilation-config '{"cudagraph_mode": "FULL_DECODE_ONLY","cudagraph_capture_sizes": [4,16,40,80,160,256,400,600,800]}' \
    --gpu-memory-utilization 0.9 \
    --enable-auto-tool-choice \
    --tool-call-parser minimax_m2 \
    --reasoning-parser minimax_m2_append_think \
    --profiler-config '{"profiler": "torch", "torch_profiler_dir": "./profile", "torch_profiler_with_stack": false}' \
    --additional-config '{"enable_cpu_binding":true}' \
    --model-loader-extra-config '{"enable_multithread_load":true,"num_threads":16}' \
    --speculative_config '{"method": "eagle3", "model": "/data/weights/MiniMax-M2.5-eagel-0318/",  "num_speculative_tokens":3}' \
    --kv-transfer-config \
    '{
        "kv_connector": "AscendStoreConnector",
        "kv_role": "kv_both",
        "kv_load_failure_policy": "recompute",
        "kv_connector_extra_config":{
        "backend": "memcache",
        "lookup_rpc_port": "0"
        }
    }' 2>&1 | tee ${LOG_FILE} &
场景二:双机服务
双机服务开启三级缓存特性,只需要在主节点拉起meta_service,然后在原有双机拉起命令上,增加开启三级缓存特性的参数。meta_service只有主节点拉起,vLLM服务主从节点都需要拉起。
主从节点vLLM服务参数配置基本相同,不同的有:网卡(nic_name),本机IP(local_ip),data-parallel-start-rank参数(主节点为0,从节点为1),headless参数(只有从节点配置)。相关内容已标记到注释,执行时需从模板删除注释。拉起命令参考如下。
步骤一 启动meta_service(只在主节点启动)
MMC_CONFIG_DIR="$(python3 -c 'from pathlib import Path; import memcache_hybrid; print(Path(memcache_hybrid.__file__).resolve().parent / "config")')"
export MMC_META_CONFIG_PATH="$MMC_CONFIG_DIR/mmc-meta.conf"
python3 -c "from memcache_hybrid import MetaService; MetaService.main()"
步骤二 启动vllm服务(主从节点都启动)
nic_name="eth0"  # 根据实际网卡名配置,主从节点不同
local_ip="xx.xx.xx.xx" # 配置为当前节点IP,主从节点不同
MASTER_IP="xx.xx.xx.xx" # 配置为主节点IP,主从节点相同
export HCCL_IF_IP=$local_ip
export GLOO_SOCKET_IFNAME=$nic_name
export TP_SOCKET_IFNAME=$nic_name
export HCCL_SOCKET_IFNAME=$nic_name
export HCCL_CONNECT_TIMEOUT=300
export HCCL_OP_EXPANSION_MODE="AIV"
export OMP_PROC_BIND=false
export OMP_NUM_THREADS=10
export HCCL_BUFFSIZE=200
export PYTORCH_NPU_ALLOC_CONF=expandable_segments:True
export VLLM_ASCEND_ENABLE_MLAPO=1
export HCCL_INTRA_ROCE_ENABLE=1
export TASK_QUEUE_ENABLE=1
export CPU_AFFINITY_CONF=1

LOG_FILE="logs/mix_$(date +%Y-%m-%d-%H-%M).log"

MMC_CONFIG_DIR="$(python3 -c 'from pathlib import Path; import memcache_hybrid; print(Path(memcache_hybrid.__file__).resolve().parent / "config")')"
export MMC_LOCAL_CONFIG_PATH="$MMC_CONFIG_DIR/mmc-local.conf"

vllm serve /data/weights/GLM-5-w8a8-new \
--host 0.0.0.0 \
--port 7000 \
--tool-call-parser glm47 \
--reasoning-parser glm45 \
--enable-auto-tool-choice \
--data-parallel-size 2 \
--data-parallel-size-local 1 \
--data-parallel-start-rank 0 \ # 主节点配置为0,从节点配置为1
--headless \ # 只有从节点需要headless参数
--data-parallel-address ${master_ip} \
--data-parallel-rpc-port 14891 \
--tensor-parallel-size 8 \
--quantization ascend \
--enable-expert-parallel \
--seed 1024 \
--max-num-seqs 64 \
--served-model-name glm-5 \
--max-model-len 35000 \
--max-num-batched-tokens 4096 \
--trust-remote-code \
--gpu-memory-utilization 0.92 \
--enable-chunked-prefill \
--enable-prefix-caching \
--async-scheduling \
--additional-config '{
  "multistream_overlap_shared_expert":true,
  "fuse_qknorm_rope": false,
  "fuse_muls_add": true,
  "enable_npugraph_ex": true
}' \
--compilation-config '{"cudagraph_mode": "FULL_DECODE_ONLY", "cudagraph_capture_sizes": [1,4,8,12,16,20,24,28,32,36,48,60,72]}' \
--speculative-config '{"num_speculative_tokens": 3, "method": "deepseek_mtp"}' \
--kv-transfer-config \
    '{
        "kv_connector": "AscendStoreConnector",
        "kv_role": "kv_both",
        "kv_load_failure_policy": "recompute",
        "kv_connector_extra_config":{
        "backend": "memcache",
        "lookup_rpc_port": "0"
        }
    }' 2>&1 | tee ${LOG_FILE} &
3.3.3.5 停止服务
# 容器内,停止服务进程
pkill -9 -f python
pkill -9 -f VLLM
pkill -9 -f mmc
4. 典型场景参考实践
按照部署章节指导,拉起服务后,可进行场景化测试。在推理过程中输入上下文序列越长,生成的KV Cache 越多,vLLM 自带前缀缓存仅能使用显存存储,无法满足长序列问答场景下的存储需求。为此采用HBM+DDR+SSD三级KVCache缓存方案,以存代算,借助DRAM与SSD扩充缓存容量,提升缓存命中率,实现推理性能优化。
为充分验证三级缓存架构的性能优势,本次选取 DRAM 最小配置场景开展测试验证。
4.1 测试准备
1. 安装aisbench工具
# 拉取aisbench源码
git clone https://gitee.com/aisbench/benchmark.git
cd benchmark/
pip3 install -e ./ --use-pep517

# 安装核心依赖
pip3 install -r requirements/api.txt
pip3 install -r requirements/extra.txt

# 验证安装,如果打印出AISBench评测工具的所有命令行的帮助信息,说明安装成功。
ais_bench -h
2. 修改aisbench测试文件
使用aisench时,需要配置好模型服务信息和数据集信息,进行如下操作:
# 查询配置文件路径
ais_bench --models vllm_api_stream_chat --custom-dataset-path /datasets/qa.jsonl --mode perf --debug --search

# 找到模型服务配置文件路径
│ --models    │ vllm_api_stream_chat │ /benchmark/ais_bench/benchmark/configs/models/vllm_api/vllm_api_stream_chat.py │

# 根据服务信息,修改配置文件
vim /benchmark/ais_bench/benchmark/configs/models/vllm_api/vllm_api_stream_chat.py
根据服务信息,修改以下参数:
models = [
    dict(
        attr="service",
        type=VLLMCustomAPIChatStream,
        abbr='vllm-api-stream-chat',
        path="/data/weights/GLM-5-w8a8-new",     # 模型权重路径,配置为实际权重位置
        model="qwen3",              # 指定服务端已加载模型名称,与拉起服务时的名称保持一致
        request_rate = 0,           # 请求发送频率
        retry = 2,                  # 每个请求最大重试次数
        host_ip = "xx.xx.xx.xx",    # 指定推理服务的IP
        host_port = 8080,           # 指定推理服务的端口
        max_out_len = 1024,          # 推理服务输出的token的最大数量
        batch_size=4,               # 请求发送的最大并发数
        trust_remote_code=False,    # tokenizer是否信任远程代码,默认False;
        generation_kwargs = dict(   # 模型推理参数
            temperature = 0.01,
            ignore_eos=False,
        )
    )
]
3. 数据集构造
aisbench支持支持的任务类型包括选择 (mcq) 和问答 (qa) 两种,数据集格式支持 .jsonl 和 .csv 两种格式的数据集,这里简单构造问答qa类型的.jsonl格式的数据集(data_test.jsonl)用于测试环境能否正常运行,读者可换成自己的数据集或者开源数据集
{"question": "Q1", "answer": ""}
{"question": "Q2", "answer": ""}
{"question": "Q3", "answer": ""}
{"question": "Q4", "answer": ""}
4. 配置完成后,测试查看是否能正常运行
ais_bench --models vllm_api_stream_chat --custom-dataset-path /path/to/data_test.jsonl --mode perf4.2 长序列问答场景性能测试
针对长序列问答场景,通过请求内容多轮循环复用来模拟重复查询,首次请求全量推理写入 KV Cache,二次请求缓存命中,体现缓存命中带来的性能提升。
使用附录中的数据集生成脚本(data_gen.py),构建高前缀复用率的超长上下文问答数据集;如单条输入序列 token 长度设置为 64k,将每条序列重复两次,形成 50% 请求重复率数据集,同时将公共前缀占比参数设定为 90%,提升 KV Cache 前缀命中概率。
python data_gen.py \
--tokenizer-dir /data/weights/GLM-5-w8a8-new \        # 权重路径
--group_size 1 \        # 同一前缀下的重复样本数
--num_groups 200 \      # 数据集条数
--tokens 64000 \        # 序列长度
--num_diff_prefix 100 \ # 重复间隔
--fraction 90           # 前缀占比
生成后的数据集jsonl文件,内容格式如下示例:
{"question": "Q1", "answer": ""}
{"question": "Q2", "answer": ""}
{"question": "Q3", "answer": ""}
{"question": "Q4", "answer": ""}
...
{"question": "Q4", "answer": ""}
{"question": "Q3", "answer": ""}
{"question": "Q2", "answer": ""}
{"question": "Q1", "answer": ""}
性能测试
# 查询配置文件路径
ais_bench --models vllm_api_stream_chat --custom-dataset-path /path/to/32000_202508167_bs222_90_prefix.jsonl --mode perf --debug --search
# 找到测试配置文件路径
│ --models    │ vllm_api_general_chat │ /benchmark/ais_bench/benchmark/configs/models/vllm_api/vllm_api_stream_chat.py │
# 修改测试配置文件
vim /benchmark/ais_bench/benchmark/configs/models/vllm_api/vllm_api_stream_chat.py
# 使用数据集进行测试
ais_bench --models vllm_api_stream_chat --custom-dataset-path /path/to/32000_202508167_bs222_90_prefix.jsonl --mode perf
4.3 测试结果
性能结果的指标解析参考文档:https://ais-bench-benchmark-rf.readthedocs.io/zh-cn/latest/base_tutorials/results_intro/performance_metric.html。
为充分验证三级缓存架构的性能优势,本次选取 DRAM 最小配置场景开展测试验证,以下为 A3 单机部署 GLM5.1-w8a8 模型的实测性能数据,其中external prefix-cache hit hate在开启多级缓存后,才会在vLLM服务日志中打印。总命中率为公式计算,不为vLLM打印值,计算公式可参考附录。
表1 长序列问答测试结果参考
| 模型 | prefix-cache | memcache + ubsio | 输入长度 | 数据集重复率 | prefix-cache hit rate | external prefix-cache hit hate | 总命中率 | TTFT平均(ms) | TTFT减少比值 |
|---|---|---|---|---|---|---|---|---|---|
| GLM5.1-w8a8 | 开启 | 关闭 | 32k | 72% | 21.4% | / | 21.4% | 11716 | / |
| 开启 | 开启 | 32k | 72% | 21.4% | 64.3% | 71.5% | 4804 | 59% |
随着多级缓存特性的开启,KVCache缓存空间增大,缓存命中率逐步提高,核心收益体现在首Tokens时延TTFT的优化,随着命中率的增高而不断降低。
5. 附录
5.1 命中率计算公式
请求首先使用prefix-cache特性进行命中(prefix-cache hit rate,记该命中率为h1)。若prefix-cache未命中(比例为1-h1),则使用分级缓存进行命中(external prefix-cache hit rate,记该命中率为h2)。
由于2种命中率的分母(查询基数)不同,总命中率不能直接相加,应采用的计算公式为:
h_all = h1 + (1-h1)*h2 = h1 + h2 - h1*h2其中prefix-cache hit rate和external prefix-cache hit rate可在vLLM服务端日志中查询得到(开启多级缓存后,才会打印external prefix-cache hit rate)。
5.2 数据集生成脚本内容
数据集生成脚本data_gen.py内容:
import argparse
import json
import os
import random
import re
from typing import List, Optional
from transformers import AutoTokenizer
class DatasetTokenGuard:
    LEGAL_PATTERN = re.compile(r'^[A-Za-z0-9 ]+$')
    def __init__(self, tokenizer):
        self.tkz = tokenizer
        self.special_ids = set(getattr(tokenizer, "all_special_ids", []) or [])
        self.vocab_total = getattr(tokenizer, "vocab_size", 0) or 0
        self.no_space_toks: List[int] = []
        self.space_toks: List[int] = []
        self.pad_token: Optional[int] = None
    def text_filter(self, raw_txt: str) -> str:
        clean_chars = (c for c in raw_txt if c.isalnum() or c == " ")
        s = "".join(clean_chars)
        for sym in ("\n", "\r", "\t"):
            s = s.replace(sym, " ")
        return s
    def check_valid(self, txt: str) -> bool:
        if not txt:
            return False
        if any(bad in txt for bad in ("\n", "\r", "\t")):
            return False
        return self.LEGAL_PATTERN.fullmatch(txt) is not None
    def ids_to_text(self, tid_list: List[int]) -> str:
        try:
            return self.tkz.decode(tid_list, clean_up_tokenization_spaces=False)
        except Exception:
            return ""
    def text_to_ids(self, txt: str) -> List[int]:
        try:
            return self.tkz.encode(txt, add_special_tokens=False)
        except Exception:
            return []
    def get_token_count(self, txt: str) -> int:
        return len(self.text_to_ids(txt))
    def build_token_pool(self):
        # 遍历词表筛选合法token
        for tid in range(self.vocab_total):
            if tid in self.special_ids:
                continue
            piece = self.ids_to_text([tid])
            if not piece or not self.check_valid(piece):
                continue
            if piece.startswith(" "):
                self.space_toks.append(tid)
            else:
                self.no_space_toks.append(tid)
        # 确定填充token
        if self.space_toks:
            self.pad_token = self.space_toks[0]
        else:
            test_strs = (" 0", " 1", " a", " A", " B", " 2")
            for ts in test_strs:
                tids = self.text_to_ids(ts)
                if tids and tids[-1] not in self.special_ids:
                    self.pad_token = tids[-1]
                    break
            if self.pad_token is None and self.no_space_toks:
                self.pad_token = self.no_space_toks[0]
        # 补充token池容量下限
        def fill_space_pool():
            supply_list = [" 0", " 1", " a", " b", " A", " B", " 2", " 3", " X", " Z"]
            for s in supply_list:
                tids = self.text_to_ids(s)
                if not tids:
                    continue
                t = tids[-1]
                if self.check_valid(self.ids_to_text([t])):
                    self.space_toks.append(t)
                    if len(self.space_toks) >= 3:
                        return
        def fill_nospace_pool():
            supply_list = ["a", "b", "A", "B", "Z", "X", "0", "1", "2"]
            for s in supply_list:
                tids = self.text_to_ids(s)
                if not tids:
                    continue
                t = tids[-1]
                dec = self.ids_to_text([t])
                if self.check_valid(dec) and not dec.startswith(" "):
                    self.no_space_toks.append(t)
                    if len(self.no_space_toks) >= 2:
                        return
        if len(self.space_toks) < 3:
            fill_space_pool()
        if len(self.no_space_toks) < 2:
            fill_nospace_pool()
        # 兜底补齐空池
        if not self.space_toks and self.pad_token is not None:
            self.space_toks.append(self.pad_token)
        if not self.no_space_toks and self.pad_token is not None:
            self.no_space_toks.append(self.pad_token)
        if self.pad_token is None:
            for tid in range(self.vocab_total):
                if tid not in self.special_ids:
                    self.pad_token = tid
                    break
        if self.pad_token is None:
            self.pad_token = 0
    def calibrate_length(self, tid_seq: List[int], target_len: int, append_tok: int) -> List[int]:
        tmp_ids = tid_seq.copy()
        max_loop = 4096
        for _ in range(max_loop):
            curr_txt = self.ids_to_text(tmp_ids)
            if not self.check_valid(curr_txt):
                curr_txt = self.text_filter(curr_txt)
            real_len = self.get_token_count(curr_txt)
            if real_len == target_len:
                return self.text_to_ids(curr_txt)
            if real_len < target_len:
                tmp_ids.append(append_tok)
            else:
                if tmp_ids:
                    tmp_ids.pop()
                else:
                    tmp_ids.append(append_tok)
        # 迭代不收敛,强制截断补齐
        if not tmp_ids:
            tmp_ids = [append_tok]
        tmp_ids = tmp_ids[:target_len]
        while len(tmp_ids) < target_len:
            tmp_ids.append(append_tok)
        final_txt = self.text_filter(self.ids_to_text(tmp_ids))
        fixed = self.text_to_ids(final_txt)
        for _ in range(256):
            if len(fixed) == target_len:
                break
            if len(fixed) < target_len:
                fixed.append(append_tok)
            else:
                fixed.pop()
        return fixed
def make_prefix_sequence(guard: DatasetTokenGuard, fix_len: int, rng: random.Random) -> List[int]:
    seq = []
    first_tok = guard.no_space_toks[0] if guard.no_space_toks else guard.pad_token
    seq.append(first_tok)
    remain = fix_len - 1
    for _ in range(remain):
        pick = rng.choice(guard.space_toks) if guard.space_toks else guard.pad_token
        seq.append(pick)
    add_t = guard.space_toks[0] if guard.space_toks else guard.pad_token
    return guard.calibrate_length(seq, fix_len, add_t)
def num_to_bit_tokens(val: int, bit_width: int, zero_tok: int, one_tok: int) -> List[int]:
    bin_str = format(val, f"0{bit_width}b")
    res = []
    for ch in bin_str:
        res.append(zero_tok if ch == "0" else one_tok)
    return res
def safe_mkdir(path: str):
    try:
        os.makedirs(path, exist_ok=True)
    except Exception:
        pass
def main_workflow():
    parser = argparse.ArgumentParser(description="测试数据集生成工具")
    parser.add_argument("--tokenizer-dir", type=str, default="/mnt/nfs/levis/DeepSeek-R1_w8a8_vllm")
    parser.add_argument("--seed", type=int, default=202508167)
    parser.add_argument("--tokens", type=int, default=3500)
    parser.add_argument("--num_diff_prefix", type=int, default=10)
    parser.add_argument("--group_size", type=int, default=5)
    parser.add_argument("--num_groups", type=int, default=40)
    parser.add_argument("--fraction", type=int, default=50)
    args = parser.parse_args()
    total_tok = args.tokens
    rng_engine = random.Random(args.seed)
    prefix_cnt = args.num_diff_prefix
    per_group_sample = args.group_size
    group_total = args.num_groups
    ratio_pct = args.fraction
    # 加载分词器
    try:
        tokenizer = AutoTokenizer.from_pretrained(args.tokenizer_dir, use_fast=True)
    except Exception:
        tokenizer = AutoTokenizer.from_pretrained(args.tokenizer_dir, use_fast=False)
    guard = DatasetTokenGuard(tokenizer)
    guard.build_token_pool()
    # 分配bit 0/1 token,保证不重复
    tok0 = guard.space_toks[0] if len(guard.space_toks)>=1 else guard.pad_token
    tok1 = guard.space_toks[1] if len(guard.space_toks)>=2 else (guard.no_space_toks[0] if guard.no_space_toks else guard.pad_token)
    if tok1 == tok0:
        combined = guard.space_toks + guard.no_space_toks
        for t in combined:
            if t != tok0:
                tok1 = t
                break
    prefix_len = max(1, total_tok * ratio_pct // 100)
    max_bit_len = 16
    bit_len = max(1, min(max_bit_len, total_tok - prefix_len))
    # 路径构造
    out_root = f"{total_tok}_{args.seed}_ds_p{prefix_cnt}_gs{per_group_sample}_ng{group_total}"
    safe_mkdir(out_root)
    path_prefix_ref = os.path.join(out_root, f"{total_tok}_{args.seed}_pre_{ratio_pct}.jsonl")
    path_full_data = os.path.join(out_root, f"{total_tok}_{args.seed}_full_{per_group_sample*group_total}_{ratio_pct}.jsonl")
    stored_prefix_list = []
    buf_prefix_lines = []
    # 批量生成前缀池
    for _ in range(prefix_cnt):
        raw_pre = make_prefix_sequence(guard, prefix_len, rng_engine)
        try:
            txt = guard.ids_to_text(raw_pre)
            if not guard.check_valid(txt):
                txt = guard.text_filter(txt)
            add_t = guard.space_toks[0] if guard.space_toks else guard.pad_token
            fixed_pre_ids = guard.calibrate_length(guard.text_to_ids(txt), prefix_len, add_t)
            pre_txt = guard.ids_to_text(fixed_pre_ids)
            buf_prefix_lines.append(json.dumps({"question": pre_txt, "answer": ""}, ensure_ascii=True))
            stored_prefix_list.append(fixed_pre_ids)
        except Exception:
            fallback_text = " ".join([f"A{x%10}" for x in range(max(1, prefix_len))])
            add_t = guard.space_toks[0] if guard.space_toks else guard.pad_token
            fall_ids = guard.calibrate_length(guard.text_to_ids(fallback_text), prefix_len, add_t)
            safe_text = guard.ids_to_text(fall_ids)
            buf_prefix_lines.append(json.dumps({"question": safe_text, "answer": ""}, ensure_ascii=True))
            stored_prefix_list.append(fall_ids)
    # 一次性写入前缀文件
    with open(path_prefix_ref, "w", encoding="utf-8") as f:
        f.write("\n".join(buf_prefix_lines)+"\n")
    # 生成完整数据集,行缓存
    data_lines = []
    for g_idx in range(group_total):
        for s_idx in range(per_group_sample):
            bit_id_seq = num_to_bit_tokens(s_idx, bit_len, tok0, tok1)
            flip_flag = (g_idx // prefix_cnt) % 2
            if flip_flag == 0:
                sel_idx = g_idx % prefix_cnt
            else:
                sel_idx = prefix_cnt - 1 - (g_idx % prefix_cnt)
            full_ids = stored_prefix_list[sel_idx].copy() + bit_id_seq
            curr_text = guard.ids_to_text(full_ids)
            used_tok = guard.get_token_count(curr_text)
            fill_num = max(0, total_tok - used_tok)
            for _ in range(fill_num):
                fill_t = rng_engine.choice(guard.space_toks) if guard.space_toks else guard.pad_token
                full_ids.append(fill_t)
            add_tok = guard.space_toks[0] if guard.space_toks else guard.pad_token
            final_ids = guard.calibrate_length(full_ids, total_tok, add_tok)
            q_text = guard.ids_to_text(final_ids)
            if not guard.check_valid(q_text):
                q_text = guard.text_filter(q_text)
            data_lines.append(json.dumps({"question": q_text, "answer": ""}, ensure_ascii=True))
    # 批量写入数据文件
    with open(path_full_data, "w", encoding="utf-8") as fw:
        fw.write("\n".join(data_lines)+"\n")
    print("数据集生成完成")
    print(f"前缀参考文件:{path_prefix_ref}")
    print(f"完整数据集:{path_full_data}")
    print(f"总token数:{total_tok}, 前缀token长:{prefix_len}, 前缀占比:{ratio_pct}%, bit编码长度:{bit_len}")
if __name__ == "__main__":
    main_workflow()